Talaxie et Apache Hop sont deux solutions ETL open source qui permettent de concevoir graphiquement des traitements de données. Leurs logiques de fonctionnement, d'industrialisation et de réutilisation diffèrent pourtant sur plusieurs points. DeciVision a conduit un travail de comparaison pour identifier dans quels contextes chacun conserve des avantages.
À la suite du POC réalisé autour d'Apache Hop, nous avons souhaité approfondir l'analyse en le comparant à Talaxie, autre solution ETL bien connue dans notre environnement. Les deux solutions sont open source et permettent de concevoir graphiquement des traitements de données. Apache Hop s'appuie sur l'écosystème Apache et une architecture modulaire, tandis que Talaxie s'inscrit davantage dans la continuité de Talend Open Studio, dont il reprend une grande partie des principes et de la compatibilité.
Tous deux permettent donc de répondre à des besoins ETL classiques, mais ils reposent sur des logiques de fonctionnement, d'industrialisation et de réutilisation qui ne sont pas totalement identiques.
C'est dans cette optique qu'un travail de comparaison a été mené chez DeciVision afin d'évaluer plus concrètement leurs différences, leurs points forts et leurs limites. L'objectif n'était pas de désigner un outil universellement meilleur que l'autre, mais plutôt de comprendre dans quels contextes Apache Hop peut constituer une alternative pertinente à Talaxie, et dans quels cas ce dernier conserve des avantages, notamment lorsqu'un existant Talend est déjà en place.
Talaxie et Apache Hop : deux logiques de fonctionnement différentes
De la conception à l'exécution
Apache Hop et Talaxie permettent tous les deux de construire graphiquement des traitements de données. À première vue, leur utilisation peut donc sembler assez proche : l'utilisateur assemble différentes étapes, configure les sources et les sorties, puis lance le traitement.
La différence apparaît surtout au moment de l'exécution. Talaxie conserve une logique proche de Talend Open Studio : le Job conçu graphiquement est transformé en code Java avant d'être exécuté. Apache Hop adopte une approche différente. Le pipeline est enregistré dans un fichier .hpl qui décrit les différentes étapes du traitement et leur configuration. Lors de l'exécution, le moteur de Hop lit directement cette définition et prend en charge les différentes étapes du pipeline.
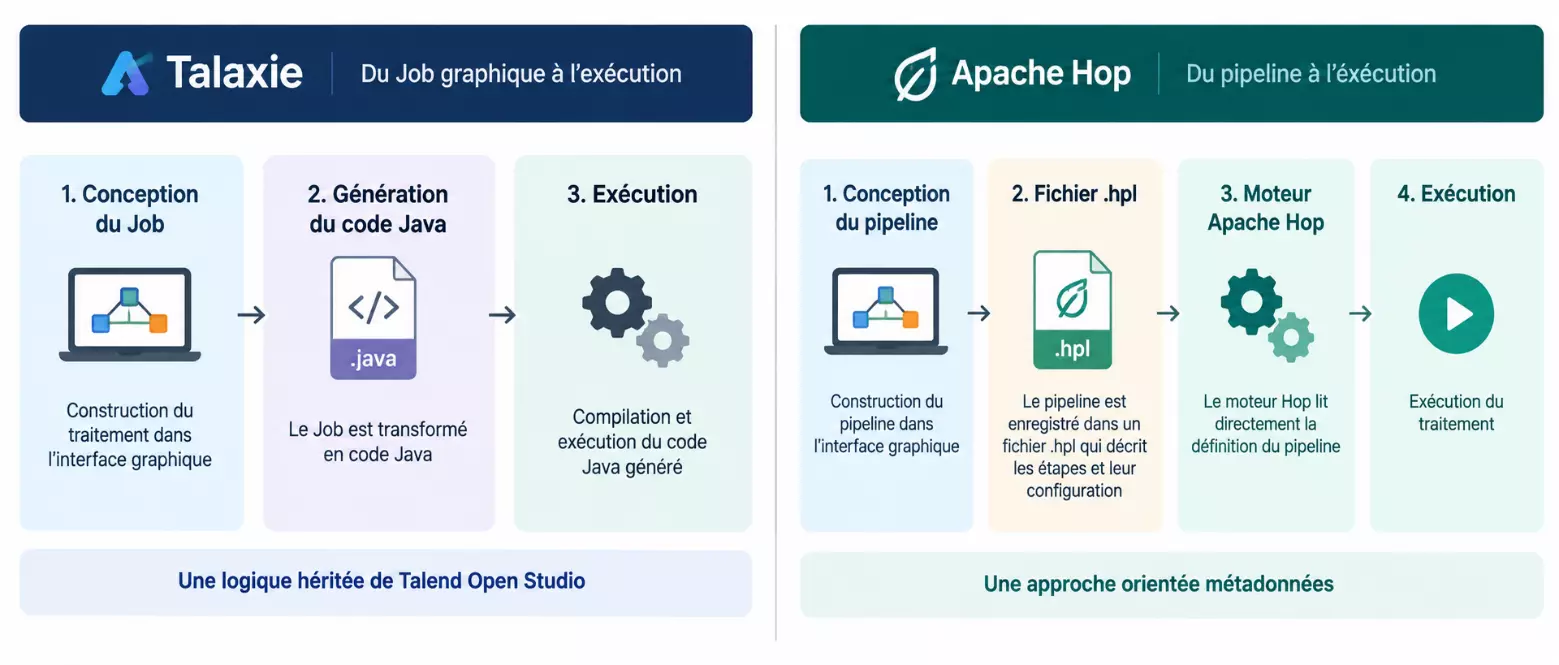
Cette différence n'empêche pas les deux outils de répondre aux mêmes besoins ETL classiques, mais elle influence leur fonctionnement et certaines possibilités abordées par la suite, notamment la manière de configurer l'exécution ou de réutiliser un même traitement.
La circulation des données pendant l'exécution
Dans les deux outils, les données peuvent être traitées progressivement sans attendre nécessairement que l'ensemble du fichier soit chargé en mémoire. La différence se situe surtout dans la manière dont cette circulation est organisée.
Dans Apache Hop, toutes les transformations d'un pipeline sont démarrées et fonctionnent en parallèle. Les lignes circulent entre elles au fur et à mesure : pendant que la source continue de lire de nouvelles données, les premières lignes peuvent déjà être transformées puis écrites en sortie. La documentation Hop présente explicitement le pipeline comme un réseau de transformations exécutées simultanément.
Dans Talaxie, pour un Job standard issu de la logique Talend, les connexions Row transmettent elles aussi les données d'un composant à l'autre ligne par ligne. Le flux principal est parcouru ligne après ligne selon la logique définie dans le Job. Certaines opérations modifient également ce comportement. Avec un tMap utilisant une jointure, par exemple, le flux de lookup doit être préparé avant le traitement des lignes du flux principal. Selon la configuration choisie, ce lookup peut être chargé une seule fois, rechargé pour chaque ligne ou mis en cache.
Deux façons d'organiser la logique d'un traitement
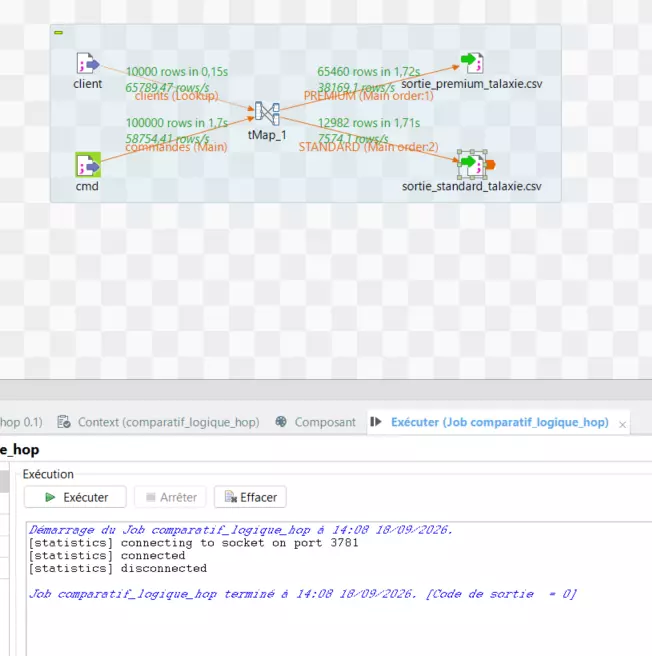
Pour comparer la manière dont Apache Hop et Talaxie structurent un traitement, un même flux a été reproduit dans les deux outils. Il repose sur deux fichiers, commandes.csv et clients.csv, et réalise successivement une jointure entre les données, un filtrage, le calcul d'un montant TTC puis une répartition des résultats entre deux sorties : PREMIUM et STANDARD.
Les deux traitements aboutissent au même résultat : 65 460 lignes PREMIUM et 12 982 lignes STANDARD. La différence apparaît surtout dans la manière dont la logique est organisée.
Talaxie : plusieurs opérations regroupées dans le tMap
Dans Talaxie, une grande partie du traitement peut être concentrée dans le tMap. Dans notre exemple, les deux sources arrivent dans ce composant, qui permet de gérer la jointure ainsi que la logique appliquée aux différentes sorties.
Apache Hop : une étape spécialisée pour chaque opération
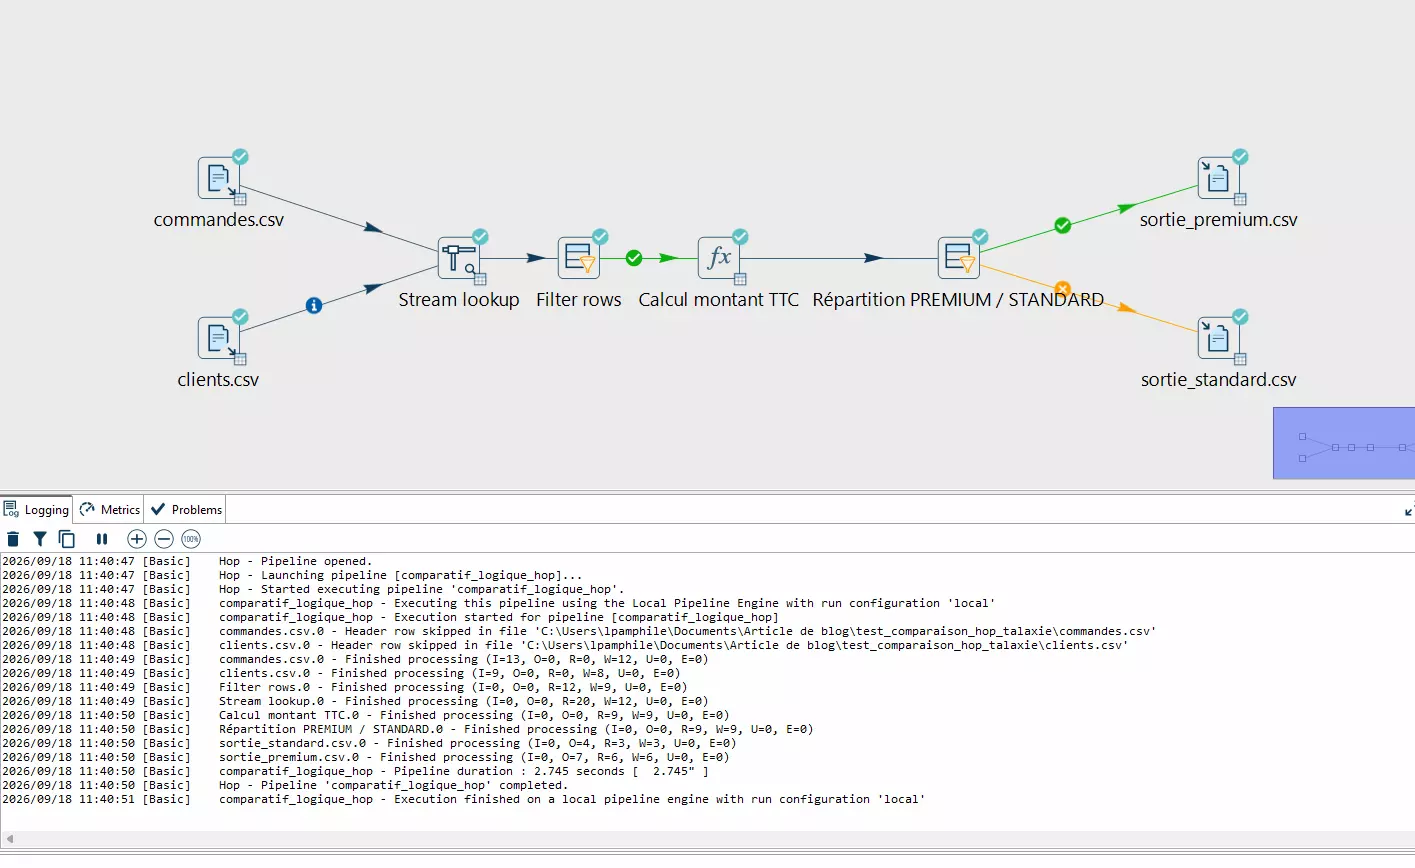
Apache Hop adopte une organisation différente. Les différentes opérations sont davantage matérialisées par des composants dédiés : Sources → Stream Lookup → Filter Rows → Calculator → Répartition → Sorties.
Dans le pipeline réalisé, Stream Lookup effectue la jointure entre les commandes et les clients, Filter Rows applique le filtrage, Calculator calcule le montant TTC et une dernière étape assure la répartition entre les sorties PREMIUM et STANDARD.
Deux philosophies de conception
Le test met ainsi en évidence deux manières d'organiser une même logique métier. Talaxie permet de centraliser plusieurs règles dans un composant comme le tMap, ce qui peut rendre le Job plus compact. Apache Hop décompose davantage le traitement en étapes spécialisées, ce qui rend chaque opération directement identifiable dans le pipeline.
Ce n'est donc pas une différence de capacité fonctionnelle dans cet exemple : les deux traitements réalisent les mêmes opérations et produisent les mêmes résultats. La différence concerne surtout la représentation de la logique et la manière dont celle-ci sera ensuite lue, modifiée et maintenue.
Le traitement et son mode d'exécution
Une autre différence concerne la manière dont le traitement est lié à son mode d'exécution.
Dans Apache Hop, le pipeline et sa configuration d'exécution sont dissociés. Le fichier .hpl contient la logique du traitement, tandis qu'une Run Configuration précise la manière dont celui-ci sera lancé.
Dans Talaxie, la logique reste davantage centrée sur le Job lui-même. Dans notre contexte, Talaxie s'appuie sur ETLTool pour gérer l'exécution et l'exploitation des traitements.
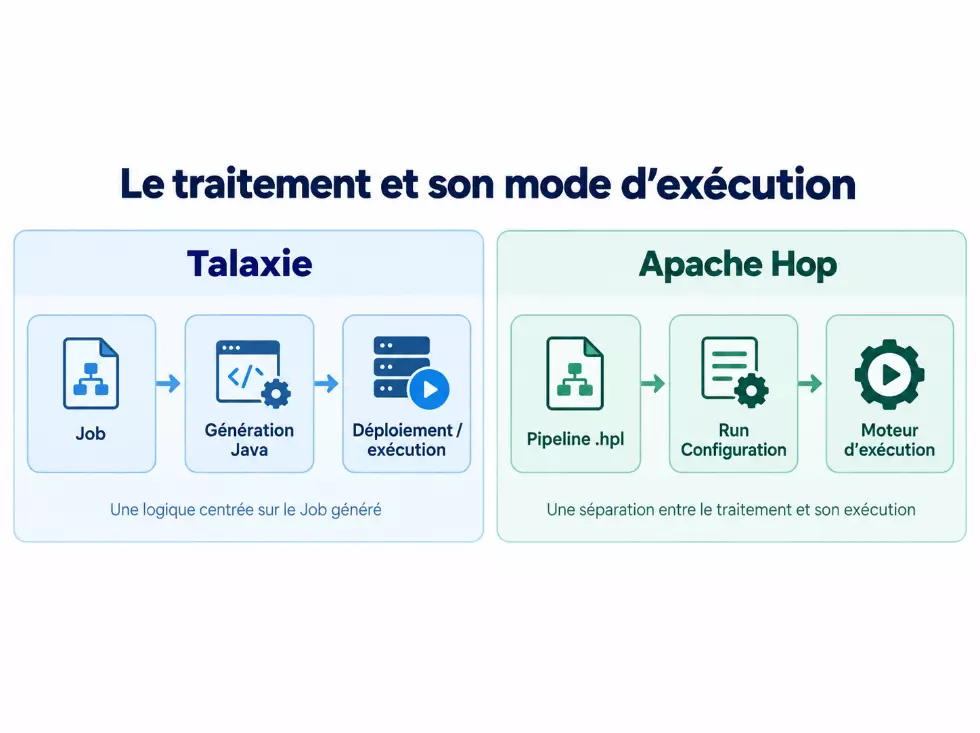
Cette distinction n'implique pas qu'une approche soit systématiquement meilleure que l'autre. Elle montre simplement que les deux outils n'organisent pas de la même manière le lien entre le traitement développé et son exécution.
Réutiliser et adapter un traitement : Talaxie face à Apache Hop
Au-delà de la construction d'un traitement, un autre enjeu important concerne sa capacité à être réutilisé dans plusieurs contextes sans multiplier les développements. Sur ce point, Apache Hop et Talaxie permettent tous deux de réemployer une même logique de traitement, mais selon des mécanismes différents.
Apache Hop : adapter un pipeline avec la Metadata Injection
Apache Hop propose une fonctionnalité appelée Metadata Injection. Son principe est de créer un pipeline modèle dont certains éléments peuvent être définis dynamiquement au moment de l'exécution.
Les informations injectées peuvent notamment concerner les noms de champs, les types de données, les fichiers utilisés ou certains paramètres des composants. Un même pipeline peut ainsi servir de base à plusieurs traitements proches, plutôt que de maintenir plusieurs pipelines presque identiques.
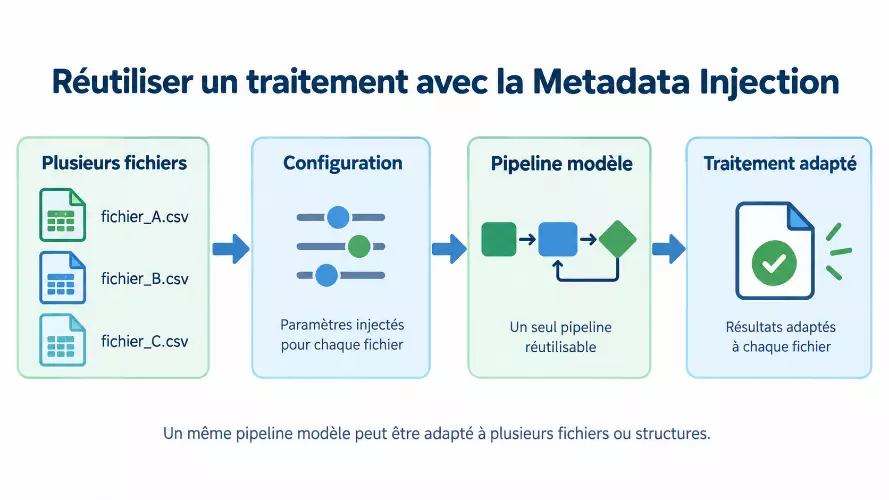
Par exemple, plusieurs fichiers CSV présentant des structures différentes peuvent être traités à partir d'un même pipeline modèle, à condition de fournir à Hop la configuration adaptée à chaque fichier.
Talaxie : réutiliser un Job par le paramétrage
Dans Talaxie, la réutilisation repose davantage sur les mécanismes de paramétrage, notamment les contextes, qui permettent d'adapter certaines valeurs selon l'environnement ou le besoin du traitement.
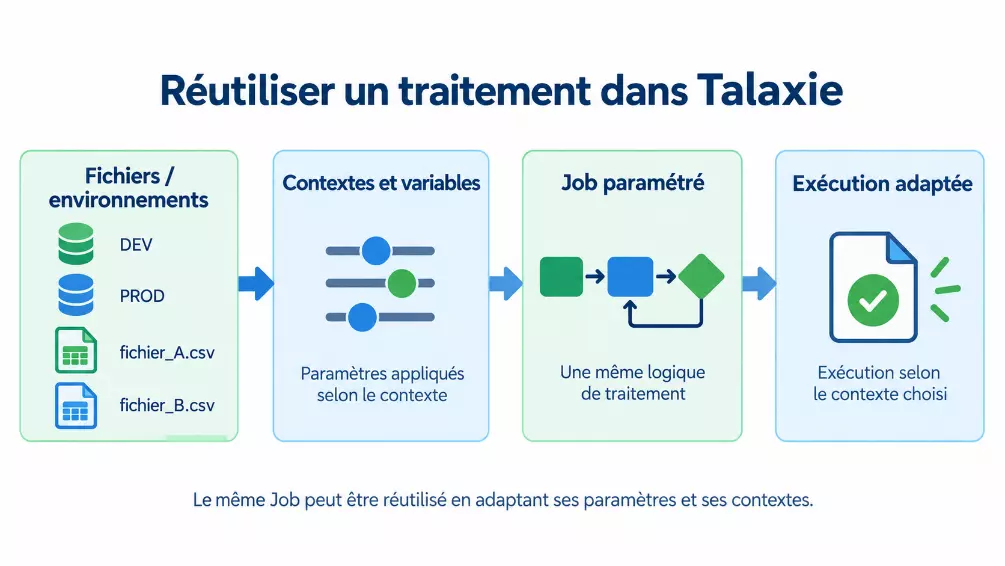
Un même Job peut ainsi être exécuté dans plusieurs contextes en faisant varier, par exemple, les chemins de fichiers, les connexions, certaines variables ou l'environnement d'exécution.
La logique n'est donc pas absente de Talaxie : là aussi, il est possible de réutiliser un même traitement. La différence tient surtout au fait que le paramétrage est davantage associé au Job et à ses variables d'exécution, tandis que dans Apache Hop la Metadata Injection permet d'agir plus directement sur une partie de la configuration du pipeline modèle.
Deux approches de la réutilisation
Les deux outils permettent donc de limiter la duplication, mais pas tout à fait de la même manière.
Avec Talaxie, on réutilise principalement un même Job en faisant varier des paramètres de contexte : chemins, connexions, valeurs ou environnement DEV/PROD.
Avec Apache Hop, on peut également réutiliser un même modèle, mais la Metadata Injection permet d'adapter plus directement certains éléments de sa configuration, comme les champs, les types, les fichiers ou certains paramètres de transformation. Cette différence devient particulièrement intéressante lorsque plusieurs traitements reposent sur une même logique générale, tout en devant s'adapter à des fichiers, des structures ou des configurations différentes.
Performances de Talaxie et Apache Hop : ce que montrent les tests
La comparaison des outils ne peut pas se limiter à leur manière de construire ou de paramétrer les traitements. Les performances d'exécution constituent également un point à prendre en compte, notamment lorsque les volumes de données augmentent.
Deux tests ont été réalisés : le premier reproduit un traitement ETL complet identique dans Apache Hop et Talaxie, tandis que le second se concentre sur une jointure avec des volumes plus importants.
Un même traitement reproduit dans les deux outils
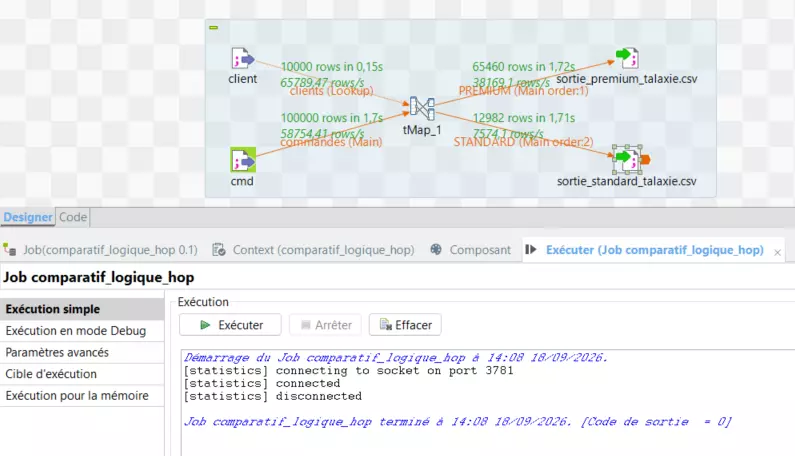
Le premier test reprend le traitement présenté précédemment. Il utilise deux fichiers contenant 100 000 commandes et 10 000 clients, puis réalise une jointure, un filtrage, un calcul de montant TTC et une répartition entre deux sorties.
Les deux outils produisent exactement le même résultat : 65 460 lignes PREMIUM et 12 982 lignes STANDARD.
Dans Apache Hop, l'exécution complète du pipeline a été mesurée à environ 2,75 secondes.
Dans Talaxie, les métriques visibles sur le traitement indiquent environ 1,7 seconde au niveau des sorties. Ces mesures ne correspondant pas exactement au même indicateur que la durée globale affichée par Hop, elles ne doivent toutefois pas être utilisées comme un benchmark strict entre les deux outils. Ce premier test confirme surtout qu'un même besoin métier peut être reproduit dans les deux outils avec un résultat identique, malgré des logiques de construction différentes. Les temps observés apportent un premier point de comparaison, sans constituer à eux seuls une conclusion sur les performances globales des deux solutions.
Tester la jointure sur des volumes plus importants
Un second test a été réalisé spécifiquement sur une jointure entre deux fichiers d'environ 900 000 lignes.
Dans Talaxie, la jointure a été réalisée à l'aide du tMap.
Dans Apache Hop, deux méthodes ont été étudiées : Stream Lookup, qui utilise l'un des flux comme référentiel et le charge en mémoire ; Merge Join, qui nécessite que les deux flux soient triés avant leur rapprochement.
Les trois traitements ont produit le même résultat, soit 890 582 lignes.
Le choix du composant et du traitement a son importance
Sur ce second test, le tMap de Talaxie obtient le temps d'exécution le plus faible.
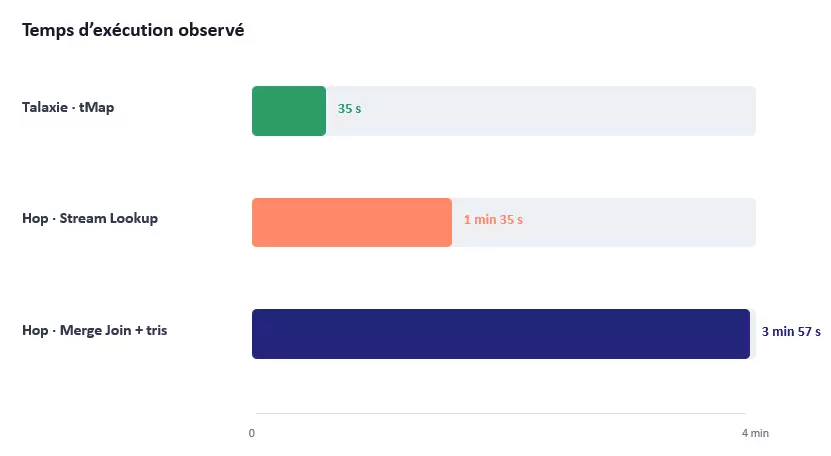
Les résultats montrent également que deux méthodes répondant au même besoin dans Apache Hop peuvent avoir des comportements différents. Dans le scénario testé, Stream Lookup est plus rapide que Merge Join avec tris. Merge Join nécessite en effet une préparation supplémentaire des deux flux lorsque ceux-ci ne sont pas déjà triés.
À l'inverse, Stream Lookup conserve son flux de référence en mémoire. Le choix entre les différentes méthodes dépend donc également du volume des données et des ressources disponibles.
Des résultats à replacer dans leur contexte
Ces tests ne permettent pas de conclure qu'un outil sera systématiquement plus rapide que l'autre. Ils correspondent à des traitements et des volumes précis, réalisés dans l'environnement du POC.
Ils montrent néanmoins que les performances peuvent varier sensiblement selon la manière dont le traitement est construit et les composants utilisés. Pour des traitements volumineux ou critiques, il reste donc pertinent de tester l'architecture retenue avec les données et les contraintes réelles du projet.
Industrialiser et exploiter les traitements avec Talaxie ou Apache Hop
Une fois les traitements développés, l'enjeu est de pouvoir les déployer, les exécuter automatiquement et les exploiter dans la durée. Sur ce point, Apache Hop et Talaxie proposent là encore des organisations différentes.
Talaxie : une exploitation centralisée avec ETLTool
Dans l'environnement étudié, Talaxie s'appuie sur ETLTool pour prendre en charge le déploiement, l'exécution et la planification des Jobs. Cela permet de regrouper plusieurs fonctions d'exploitation autour des traitements développés dans Talaxie.
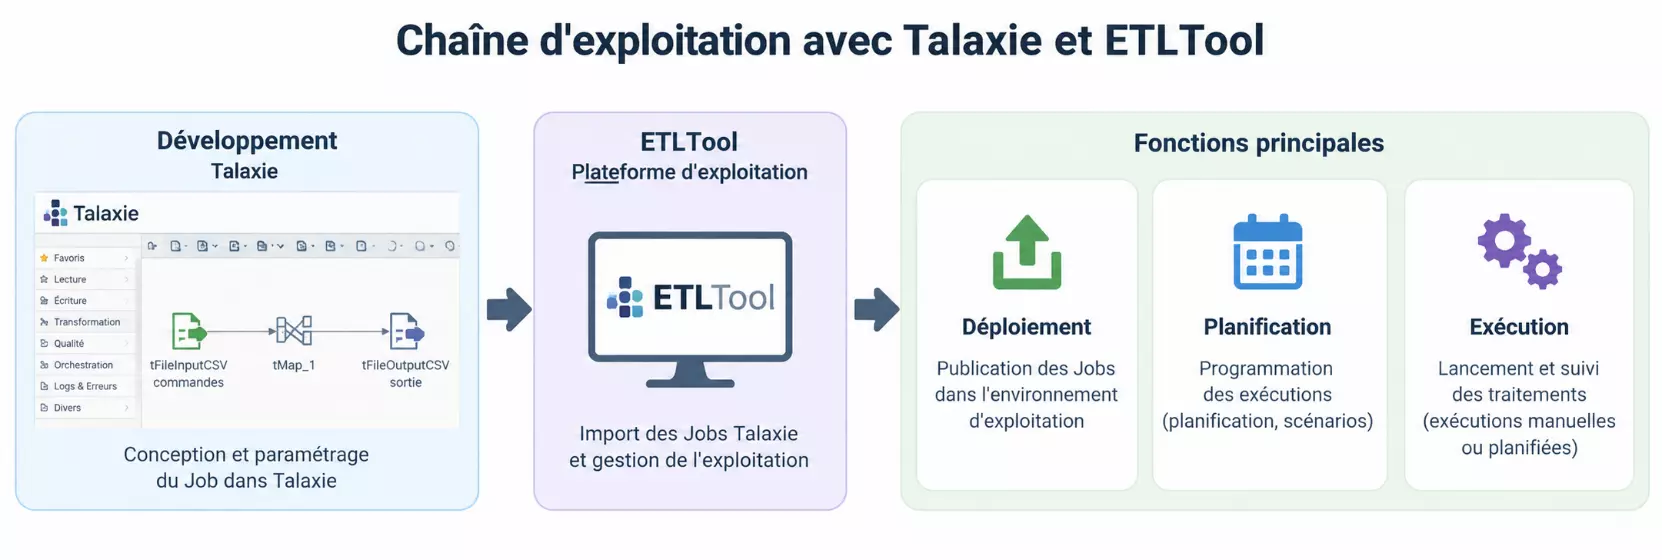
Le passage du développement à l'exploitation peut ainsi être représenté de manière relativement directe.
Apache Hop : une chaîne plus modulaire
Apache Hop adopte une approche plus découpée. Les pipelines peuvent être exécutés en ligne de commande avec hop-run ou à distance via Hop Server. La planification peut ensuite être confiée à un outil externe, par exemple cron, le Planificateur de tâches Windows ou un ordonnanceur déjà présent dans l'entreprise.
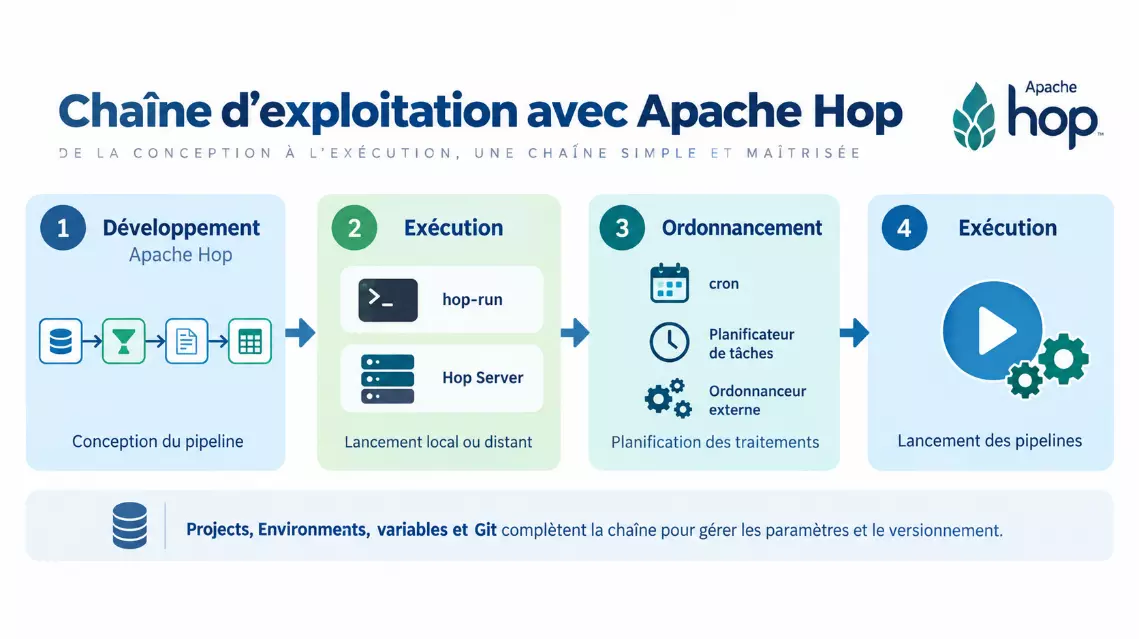
Apache Hop intègre également une gestion des Projects, Environments et variables, qui permet d'adapter les paramètres selon l'environnement utilisé. Les fichiers de configuration et de pipeline peuvent par ailleurs être versionnés avec Git.
Deux manières d'organiser l'exploitation
La différence tient donc surtout au niveau d'intégration des différents éléments. Avec Talaxie et ETLTool, plusieurs fonctions liées à l'exploitation sont regroupées dans le même environnement.
Avec Apache Hop, les différentes briques peuvent être assemblées selon l'architecture déjà présente : Hop prend en charge l'exécution du traitement, tandis que la planification ou certaines fonctions d'orchestration peuvent être confiées à des outils externes.
Aucune de ces approches n'est systématiquement préférable. Une chaîne plus intégrée peut simplifier l'exploitation lorsque l'environnement est déjà en place, tandis qu'une organisation plus modulaire permet de s'appuyer sur les outils déjà utilisés dans l'entreprise.
Dans quels contextes utiliser Hop ou Talaxie ?
Les deux outils couvrent les principaux besoins ETL étudiés, mais les différences observées au cours des tests peuvent devenir plus ou moins intéressantes selon le contexte du projet. Le choix dépend donc moins d'une opposition directe entre les solutions que des contraintes rencontrées.
| Situation | Talaxie | Apache Hop |
|---|---|---|
| Un existant Talend doit être repris | La proximité avec Talend Open Studio permet de conserver une grande partie des Jobs et des habitudes de développement existantes. | Les traitements doivent être reconstruits sous forme de pipelines Hop, ce qui peut en revanche être l'occasion de repartir sur une architecture différente. |
| Un nouveau projet ETL démarre sans existant particulier | Le tMap permet de concentrer plusieurs opérations dans un même composant et ETLTool peut fournir une chaîne d'exploitation déjà structurée. | L'absence de dépendance à un existant permet de profiter directement de la logique modulaire de Hop, de Git, des Projects/Environments et des configurations d'exécution. |
| Plusieurs traitements proches doivent être réutilisés | Les contextes et variables permettent de conserver le même Job tout en faisant varier les chemins, connexions ou paramètres selon le contexte. | La Metadata Injection permet, lorsque le besoin s'y prête, de partir d'un pipeline modèle et d'en faire varier certains champs, types, fichiers ou paramètres. |
| Le traitement concentre beaucoup de jointures, filtres, calculs et sorties | Le tMap permet de regrouper une partie importante de cette logique dans un seul composant, ce qui peut rendre le Job plus compact. | Les opérations sont davantage réparties entre des composants spécialisés, ce qui rend chaque étape directement visible dans le pipeline. |
| Une chaîne d'exploitation doit être mise en place | Avec ETLTool, déploiement, planification et exécution peuvent être regroupés dans un même environnement. | Hop peut s'intégrer à une chaîne existante avec hop-run, Hop Server et un ordonnanceur externe, ce qui laisse davantage de liberté dans l'assemblage des briques. |
| Le traitement doit pouvoir changer de mode d'exécution | L'exploitation reste principalement organisée autour du Job généré et de son environnement d'exécution. | Le pipeline est séparé de sa Run Configuration, ce qui permet d'associer le même traitement à différentes configurations d'exécution, sous réserve de compatibilité des composants. |
| Les volumes deviennent importants | Sur le test de jointure réalisé, le tMap a obtenu le temps le plus faible, avec environ 35 secondes. | Les résultats ont davantage varié selon le composant : environ 1 min 35 avec Stream Lookup et 3 min 57 avec Merge Join et ses tris. Ces résultats rendent particulièrement important le choix du composant. |
Les différences sur la compatibilité Talend, l'industrialisation, la conception des traitements et les configurations d'exécution correspondent aux éléments identifiés dans le comparatif. Les résultats de performances concernent uniquement le benchmark réalisé sur les deux sources d'environ 900 000 lignes et ne doivent pas être généralisés à tous les traitements.
Conclusion de l'expert : Talaxie ou Apache Hop ?
Les tests réalisés montrent qu'Apache Hop et Talaxie répondent tous les deux aux principaux besoins ETL étudiés, mais avec des approches différentes dans la manière de construire, paramétrer et exploiter les traitements.
Talaxie conserve un intérêt particulier lorsqu'un existant Talend est déjà présent ou lorsqu'une chaîne d'exploitation autour d'ETLTool est en place. Apache Hop se distingue davantage par son architecture modulaire, la séparation entre pipeline et configuration d'exécution, ainsi que par des fonctionnalités comme la Metadata Injection.
Les tests de performance rappellent également qu'il ne suffit pas de comparer les fonctionnalités des outils : le choix des composants et la manière de construire le traitement peuvent avoir un impact important sur les temps d'exécution, en particulier sur des volumes élevés.
Il ne s'agit donc pas de remplacer systématiquement Talaxie par Apache Hop, ni l'inverse. Le choix dépend avant tout du contexte du projet, de l'existant technique, des contraintes d'exploitation et de la nature des traitements à mettre en place. Apache Hop constitue néanmoins une alternative crédible à considérer pour de nouveaux projets ETL, avec une validation des performances lorsque les volumes deviennent importants.
À retenir
- Apache Hop et Talaxie couvrent les mêmes besoins ETL classiques, mais leurs logiques de construction et d'exécution diffèrent.
- Talaxie est avantagé quand un existant Talend est déjà en place : les Jobs et les habitudes de développement sont en grande partie conservés.
- Apache Hop sépare le pipeline de sa configuration d'exécution (Run Configuration), ce qui facilite le changement de mode d'exécution sans modifier le traitement.
- La Metadata Injection d'Apache Hop permet de créer un pipeline modèle dont certains champs, types ou fichiers sont définis dynamiquement à l'exécution.
- Sur les tests de performance, le tMap de Talaxie obtient le temps le plus faible sur la jointure à volume élevé. Dans Apache Hop, les résultats varient selon le composant choisi (Stream Lookup vs. Merge Join).
- Le choix entre les deux outils dépend avant tout du contexte : existant technique, contraintes d'exploitation, nature des traitements et volumes à traiter.
Vous travaillez avec Talaxie ou envisagez de migrer depuis Talend ?
DeciVision vous accompagne sur vos projets ETL et Data Integration.
Questions fréquentes
Quelle est la différence entre Talaxie et Apache Hop ?
Talaxie s'inscrit dans la continuité de Talend Open Studio, dont il reprend les principes et une grande partie de la compatibilité. Apache Hop repose sur une architecture modulaire : le pipeline est enregistré dans un fichier .hpl et son mode d'exécution est dissocié dans une Run Configuration distincte. Les deux outils permettent de construire graphiquement des traitements ETL, mais ils diffèrent dans leur organisation de la logique, leur gestion de la réutilisation et leur approche de l'industrialisation.
Faut-il migrer de Talaxie vers Apache Hop ?
Pas nécessairement. Talaxie conserve un intérêt fort lorsqu'un existant Talend est déjà en place : les Jobs et les habitudes de développement sont en grande partie préservés. Apache Hop constitue une alternative pertinente pour de nouveaux projets ETL sans dépendance à un existant, en particulier quand la modularité, la gestion des environnements et la Metadata Injection apportent de la valeur. Le choix dépend avant tout du contexte technique et des contraintes d'exploitation.
Talaxie est-il plus performant qu'Apache Hop ?
Sur les tests réalisés par DeciVision, le tMap de Talaxie a obtenu le temps d'exécution le plus faible sur une jointure entre deux fichiers d'environ 900 000 lignes. Les résultats d'Apache Hop ont davantage varié selon le composant utilisé : Stream Lookup s'est révélé plus rapide que Merge Join avec tris dans ce scénario. Ces mesures correspondent à des volumes et des configurations précis et ne peuvent pas être généralisés à tous les traitements.
Comment Apache Hop gère-t-il la réutilisation des traitements ?
Apache Hop propose la Metadata Injection, qui permet de créer un pipeline modèle dont certains éléments (noms de champs, types de données, fichiers, paramètres de composants) sont définis dynamiquement à l'exécution. Un même pipeline peut ainsi servir de base à plusieurs traitements proches, sans multiplier les développements. Talaxie repose davantage sur les contextes et variables pour faire varier les chemins, connexions ou paramètres d'un même Job selon l'environnement.