Apache Hop : fonctionnement, industrialisation et cas d'usage d'un ETL open source
Dans nos projets d'intégration de données, nous travaillons régulièrement avec des traitements qui doivent être maintenus, réutilisés, automatisés ou déployés dans plusieurs environnements. Le choix de l'outil ETL et de son architecture pèse alors directement sur la façon dont ces traitements pourront évoluer dans le temps. C'est dans ce cadre que nous avons voulu étudier Apache Hop et tester certaines de ses fonctionnalités à travers un POC réalisé chez DeciVision.
Apache Hop, qu'est-ce que c'est ?
Apache Hop (Hop Orchestration Platform) est une plateforme open source dédiée à l'intégration et à l'orchestration des données. Elle permet de concevoir visuellement des traitements capables de collecter, contrôler, transformer, enrichir et charger des données issues de sources variées : fichiers, bases de données, API ou applications.
Son interface graphique, Hop GUI, permet de construire ces traitements en assemblant différents composants. Cette approche visuelle facilite la conception, la compréhension et la maintenance des flux.
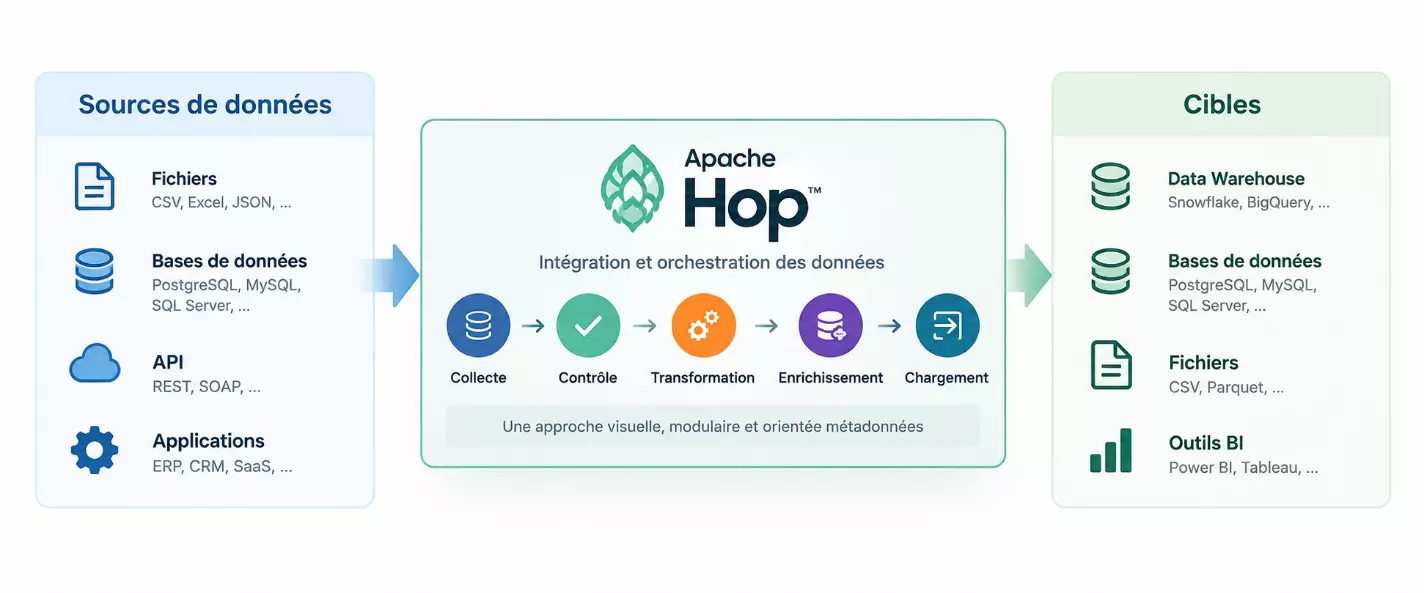
Apache Hop ne se limite toutefois pas à une simple interface graphique. L'un de ses principaux atouts repose sur une approche orientée métadonnées : les connexions, variables, environnements ou configurations d'exécution peuvent être définis séparément des traitements, puis réutilisés. Cette organisation favorise la réutilisation, la portabilité et l'industrialisation des flux.
Apache Hop trouve son origine dans Kettle, technologie à l'origine de Pentaho Data Integration (PDI), dont il reprend certains principes. Depuis, la solution a évolué de manière indépendante avec une architecture plus modulaire et davantage orientée métadonnées. Elle fait aujourd'hui partie de l'écosystème de l'Apache Software Foundation et est distribuée sous licence open source Apache 2.0.
Comment fonctionne Apache Hop ?
Apache Hop repose sur une logique visuelle dans laquelle les traitements sont construits à partir de composants reliés entre eux. Son fonctionnement s'articule principalement autour de deux objets : les pipelines, chargés de traiter les données, et les workflows, qui permettent d'organiser et d'orchestrer leur exécution.
Les pipelines : le cœur du traitement des données
Un pipeline est constitué de Transforms reliés entre eux par des Hops. Chaque Transform réalise une opération précise : lecture, filtrage, calcul, conversion, jointure, enrichissement ou encore écriture des données.
Le fonctionnement d'un pipeline repose sur un traitement en flux. Plusieurs Transforms peuvent être actifs simultanément et les données sont transmises progressivement d'une étape à l'autre. Entre deux Transforms, Apache Hop utilise des Row Sets, des buffers temporaires qui transmettent les lignes tout en laissant chaque composant travailler à son propre rythme.
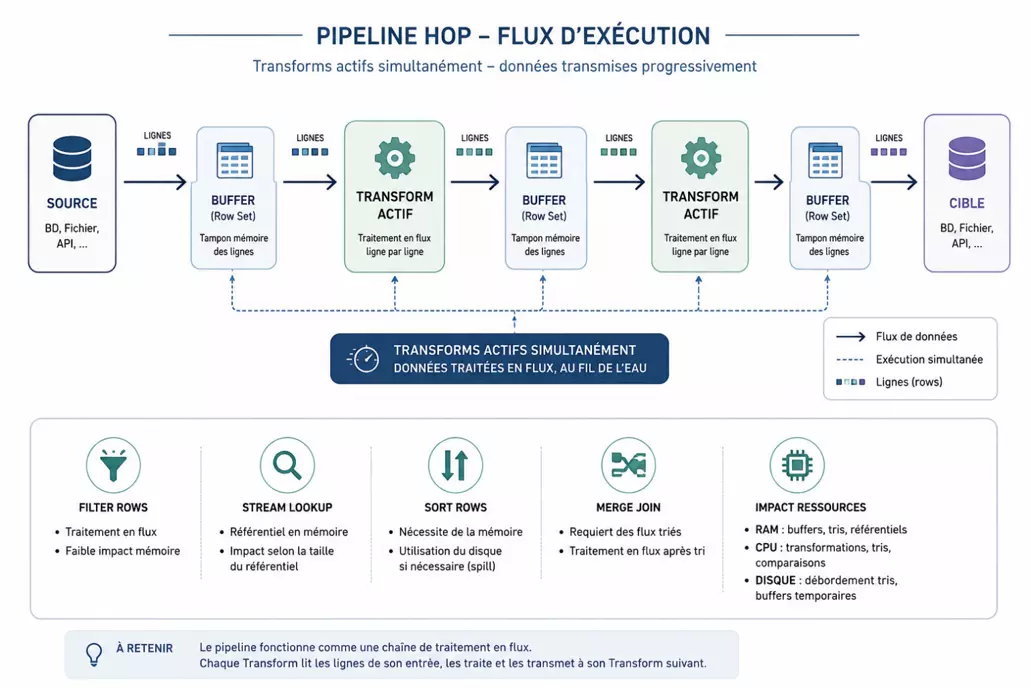
Cette architecture permet de commencer à traiter les données sans attendre systématiquement la fin complète de l'étape précédente. Le comportement dépend toutefois du Transform utilisé : certains composants travaillent directement en flux, tandis que d'autres peuvent nécessiter davantage de mémoire ou de stockage temporaire, notamment lors de tris, jointures ou recherches dans des référentiels.
Le choix des composants joue donc un rôle important dans les performances d'un pipeline, en particulier lorsque les volumes de données augmentent.
Les workflows : organiser l'exécution des traitements
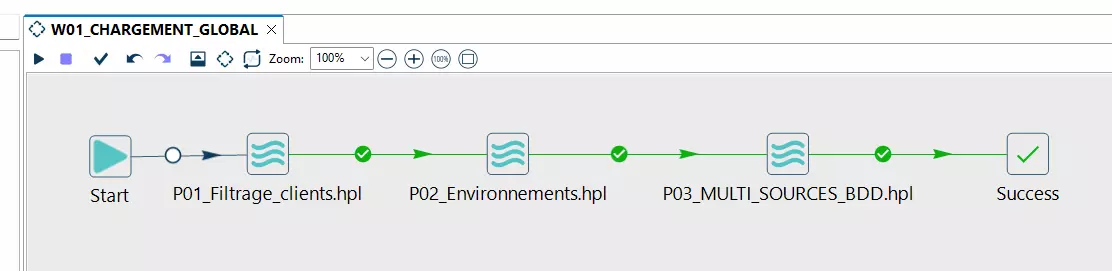
Les workflows complètent les pipelines. Leur rôle n'est pas de transformer directement les données, mais d'organiser l'enchaînement des traitements et des actions nécessaires à leur exécution.
Un workflow peut par exemple lancer plusieurs pipelines dans un ordre défini, contrôler le succès ou l'échec d'une étape et déclencher la suite du traitement en fonction du résultat obtenu.
Une approche basée sur les métadonnées, les projets et les environnements
Apache Hop sépare la logique des traitements de leur configuration technique. Les connexions aux bases de données, les variables ou encore les configurations d'exécution peuvent être définies comme des métadonnées, puis réutilisées dans plusieurs pipelines et workflows.
Les développements sont organisés au sein d'un Project, qui centralise les pipelines, les workflows, les métadonnées et les fichiers nécessaires au traitement. Une variable comme ${PROJECT_HOME} permet notamment de référencer les ressources du projet sans dépendre d'un chemin propre à une machine.
Les Environments complètent cette organisation en permettant d'utiliser un même projet dans plusieurs contextes, par exemple DEV, TEST ou PROD. Chaque environnement porte ses propres paramètres techniques, comme le serveur utilisé, la base de données cible ou le répertoire de travail, sans que le traitement lui-même ait besoin d'être modifié.
| Paramètre | DEV | PROD |
|---|---|---|
| Serveur | serveur-dev | serveur-prod |
| Base | ventes_dev | ventes_prod |
| Répertoire | /data/dev | /data/prod |
Le traitement reste identique : seules les valeurs fournies par l'environnement changent.
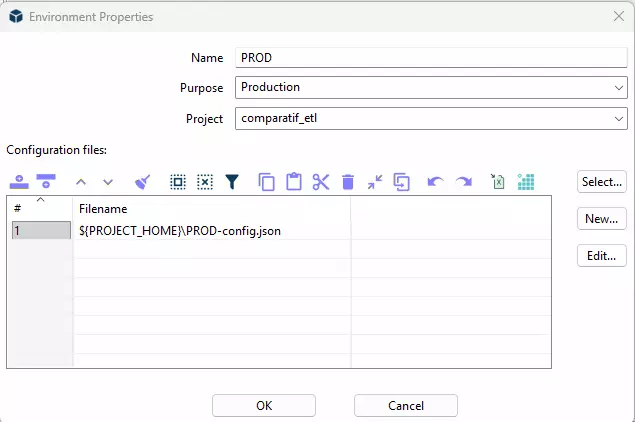
Cette organisation limite les valeurs écrites en dur dans les pipelines et facilite leur réutilisation, leur portabilité et leur déploiement entre plusieurs environnements.
Les atouts d'Apache Hop et les usages auxquels il se prête
Apache Hop se distingue notamment par sa souplesse d'architecture et par la séparation entre la logique des traitements et leur configuration. Plusieurs de ses fonctionnalités deviennent particulièrement intéressantes lorsque les traitements doivent être réutilisés, automatisés ou adaptés à différents contextes.
Metadata Injection : éviter la duplication des traitements
La Metadata Injection permet de concevoir un pipeline modèle dont certains paramètres sont définis dynamiquement au moment de l'exécution. Une même logique de traitement peut ainsi être appliquée à plusieurs fichiers, structures ou configurations, plutôt que de maintenir plusieurs pipelines très proches.
Concrètement, un pipeline conçu pour lire, nettoyer et charger un fichier CSV peut, grâce à ce mécanisme, traiter automatiquement une dizaine de fichiers aux structures voisines (colonnes différentes, sources différentes) sans dupliquer la logique : seuls les paramètres injectés changent d'une exécution à l'autre.
Cette approche est particulièrement adaptée aux traitements répétitifs ou fortement paramétrables.
Séparer le traitement de son mode d'exécution
Apache Hop distingue le pipeline de sa Run Configuration, qui définit la manière dont celui-ci sera exécuté. Un même traitement peut ainsi être lancé localement, à distance via Hop Server ou, lorsque les composants utilisés sont compatibles, avec d'autres moteurs d'exécution.
Cette séparation permet de faire évoluer le contexte d'exécution sans avoir à redéfinir la logique du pipeline.
Une architecture ouverte pour l'industrialisation
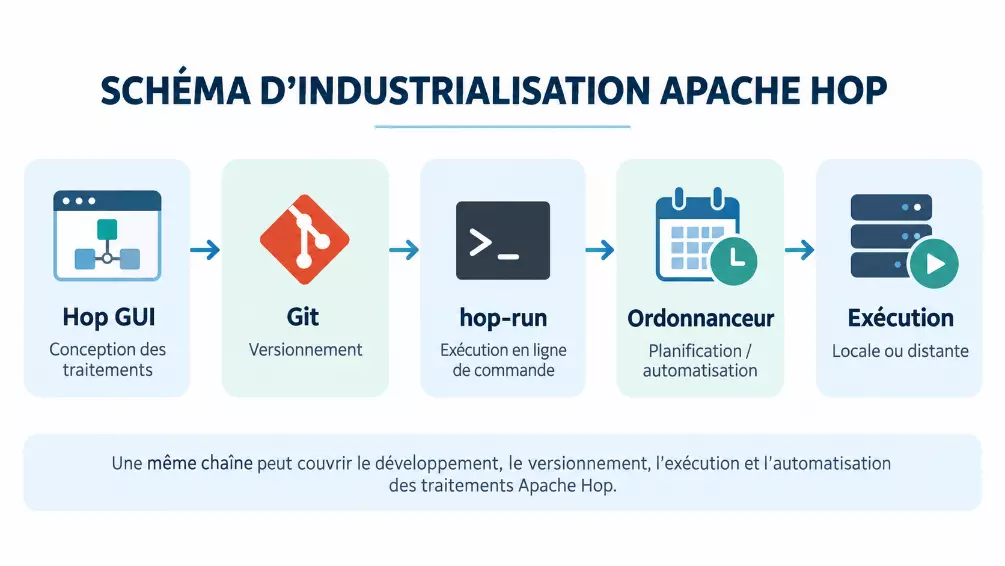
Les traitements Apache Hop ne dépendent pas uniquement de Hop GUI. Ils peuvent être exécutés en ligne de commande avec hop-run, versionnés avec Git et intégrés à des outils externes de planification ou d'automatisation.
Cette ouverture permet d'inscrire Apache Hop dans une chaîne technique plus large, dans laquelle le développement, le versionnement, l'exécution et l'ordonnancement peuvent être pris en charge par des outils spécialisés.
Dans quels contextes Apache Hop est-il particulièrement pertinent ?
Les fonctionnalités d'Apache Hop répondent à plusieurs besoins courants dans les projets d'intégration de données :
| Besoin | Apport d'Apache Hop |
|---|---|
| Nouveau projet ETL open source | Solution sans coût de licence et architecture modulaire |
| Plusieurs environnements DEV / TEST / PROD | Projects, Environments et variables |
| Traitements répétitifs ou paramétrables | Metadata Injection |
| Travail en équipe | Versionnement Git et Visual Diff |
| Automatisation des traitements | hop-run et intégration à un ordonnanceur |
Les tests réalisés dans le cadre du POC DeciVision ont notamment permis de valider des usages de lecture, transformation, jointure, gestion des erreurs, gestion des environnements et exécution automatisable.
Points de vigilance
Apache Hop reste un outil dont l'efficacité dépend fortement de la manière dont les traitements sont conçus. Le choix des Transforms peut avoir un impact important sur les performances et la consommation de ressources, en particulier lors des tris, des jointures ou des recherches dans des référentiels.
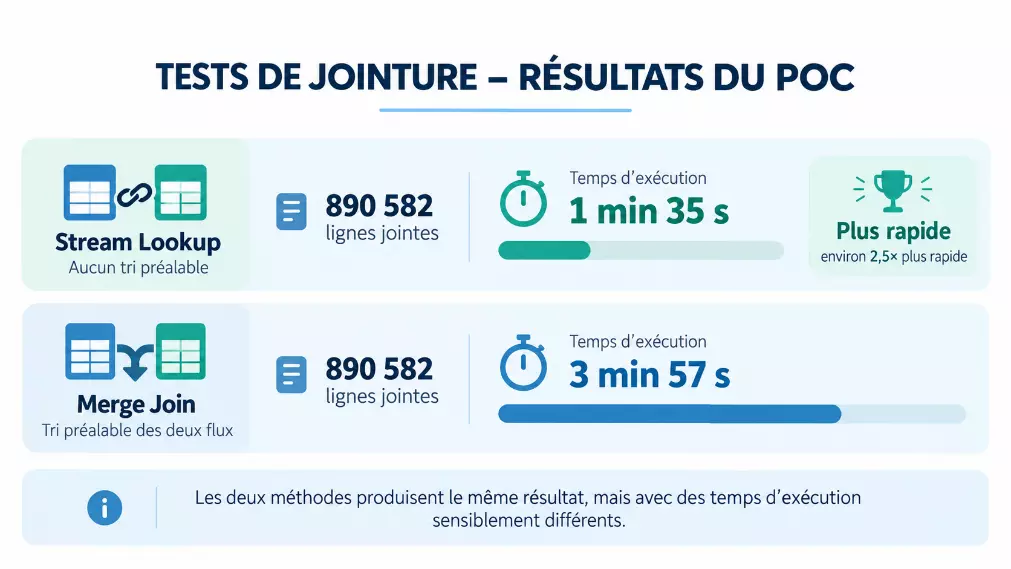
Les tests réalisés dans le POC sur différentes méthodes de jointure ont d'ailleurs montré que deux approches produisant un résultat équivalent pouvaient présenter des temps d'exécution sensiblement différents.
Au-delà des aspects techniques, Apache Hop reste un outil porté par une communauté plus restreinte que celle d'un Talend ou d'un PDI/Pentaho, ce qui peut se traduire par un support communautaire moins immédiat sur des cas très spécifiques. C'est un point à garder en tête dans l'arbitrage, notamment pour des projets à fort enjeu de support.
À retenir
- Apache Hop sépare la logique des traitements (pipelines et workflows) de leur configuration technique (métadonnées, Projects, Environments)
- La Metadata Injection permet d'appliquer un même pipeline modèle à plusieurs fichiers ou structures, sans dupliquer les traitements
- Une architecture ouverte (hop-run, Git, ordonnanceurs externes) permet d'inscrire Apache Hop dans une démarche d'industrialisation
- Sa communauté, plus restreinte que celle de Talend ou de PDI/Pentaho, est un point de vigilance pour les projets à fort enjeu de support
Conclusion de l'expert DeciVision
Apache Hop ne se résume pas à un ETL graphique. Son intérêt réside surtout dans la manière dont il structure les traitements : une approche orientée métadonnées, une séparation entre logique et configuration, ainsi que des projets pouvant être adaptés à plusieurs environnements sans modifier les pipelines.
Son architecture ouverte permet également d'aller au-delà du développement dans Hop GUI : tests, versionnement Git, exécution en ligne de commande et intégration à des outils externes permettent d'inscrire les traitements dans une démarche d'industrialisation.
Dans notre expérience via le POC DeciVision, Apache Hop s'est montré particulièrement convaincant pour des projets ETL nécessitant une architecture modulaire et multi-environnements sans coût de licence, typiquement des structures qui migrent d'un outil propriétaire ou démarrent un projet data sans historique technique lourd. À l'inverse, pour des équipes déjà installées sur un écosystème mature type Talend, avec des besoins de support poussé ou des connecteurs très spécifiques, l'intérêt d'une migration doit être évalué au regard des connecteurs utilisés, des besoins de support et de l'investissement déjà réalisé dans l'écosystème existant.
Apache Hop constitue ainsi une solution à considérer pour construire des chaînes de traitement modulaires, portables et automatisables, notamment dans des environnements recherchant une alternative open source. L'automatisation peut ensuite être complétée par un outil d'orchestration dédié : ce sera l'objet d'un prochain article consacré à Apache Airflow.
Un projet d'intégration de données à cadrer ?
Nos consultants Data Integration échangent avec vous sur le choix d'un ETL, son architecture et sa trajectoire d'industrialisation.
Pour aller plus loin sur nos travaux d'intégration de données, retrouvez l'ensemble des articles de la catégorie Data Integration sur notre blog, ou découvrez notre offre d'accompagnement ETL et Data Integration.
Questions fréquentes
Qu'est-ce qu'Apache Hop ?
Apache Hop (Hop Orchestration Platform) est une plateforme open source d'intégration et d'orchestration de données. Elle permet de concevoir visuellement, via son interface Hop GUI, des traitements qui collectent, contrôlent, transforment, enrichissent et chargent des données issues de fichiers, bases de données, API ou applications. Elle est distribuée sous licence Apache 2.0.
Quelle est la différence entre un pipeline et un workflow dans Apache Hop ?
Un pipeline traite les données elles-mêmes : il est constitué de Transforms reliés par des Hops, et fonctionne en flux grâce à des Row Sets. Un workflow, lui, ne transforme pas les données : il organise l'enchaînement des traitements, par exemple en lançant plusieurs pipelines dans un ordre défini et en réagissant au succès ou à l'échec de chaque étape.
Qu'est-ce que la Metadata Injection dans Apache Hop ?
La Metadata Injection permet de concevoir un pipeline modèle dont certains paramètres sont définis dynamiquement à l'exécution. Un même pipeline peut ainsi traiter plusieurs fichiers ou structures proches sans dupliquer la logique de traitement : seuls les paramètres injectés changent d'une exécution à l'autre.
Apache Hop est-il un outil payant ?
Non. Apache Hop est un projet de l'Apache Software Foundation, distribué sous licence open source Apache 2.0, sans coût de licence. Il peut être exécuté localement, en ligne de commande avec hop-run, ou à distance via Hop Server.
Dans quel contexte privilégier Apache Hop plutôt que Talend ou Pentaho ?
Apache Hop est particulièrement pertinent pour un nouveau projet ETL nécessitant une architecture modulaire et multi-environnements sans coût de licence, par exemple lors d'une migration depuis un outil propriétaire. Pour une équipe déjà installée sur un écosystème mature comme Talend, avec des besoins de support poussé ou des connecteurs très spécifiques, l'intérêt d'une migration reste à évaluer au regard de l'existant.